
Memangkas VRAM Model Diffusi Tanpa Kehilangan Presisi Lewat Nunchaku Lite
Integrasi native Nunchaku Lite di Hugging Face Diffusers memotong penggunaan VRAM hingga setengahnya tanpa kompilasi CUDA lokal.
Model ini tidak salah. Ia hanya tidak sedang berpikir.”
Apa yang Sebenarnya Terjadi Saat Model Diffusi Dikuantisasi?
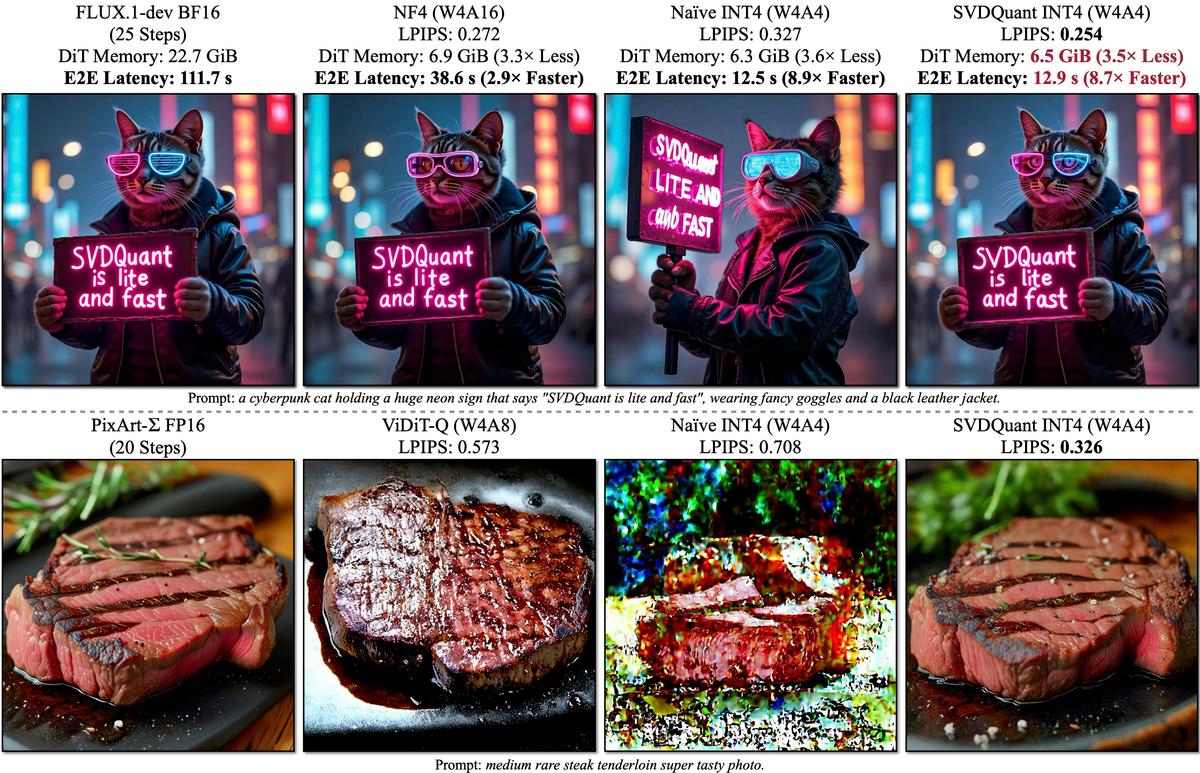
Bayangkan sebuah model diffusi sebagai pabrik raksasa yang memproses jutaan produk sekaligus di jalur perakitan. Jalur perakitan itu adalah bobot (weights) dan aktivasi (activations) dari jaringan neural. Standar kuantisasi 4-bit biasanya gagal pada model diffusi karena adanya outliers—nilai ekstrem yang merusak akurasi jika dipaksa masuk ke rentang angka sempit.
SVDQuant menyelesaikan masalah ini dengan kecerdikan tingkat tinggi. Bayangkan kamu memisahkan bagian manajer pabrik yang rewel (outliers) ke ruangan khusus berpresisi tinggi (cabang low-rank 16-bit), sementara para pekerja pabrik lainnya cukup menggunakan instruksi ringkas 4-bit. Hasilnya adalah metode W4A4 (4-bit bobot dan aktivasi) yang berjalan mulus tanpa kehilangan detail visual.
Bagaimana Nunchaku Lite Menghapus Kebutuhan Kompilasi CUDA
Versi asli mesin inferensi Nunchaku terkenal sangat cepat, namun ia menuntut modifikasi mendalam dan kompilasi CUDA lokal yang melelahkan bagi setiap arsitektur model baru. Nunchaku Lite hadir untuk menjembatani hambatan tersebut.
Bayangkan Nunchaku Lite sebagai adaptor universal listrik yang langsung pas di stopkontak mana pun tanpa perlu membongkar kabel dinding. Diffusers kini dapat memuat checkpoint gaya Nunchaku secara native menggunakan perintah standar `from_pretrained()`.
Di balik layar, Nunchaku Lite menambal modul `nn.Linear` standar dari model Diffusers dengan lapisan runtime khusus sesaat sebelum checkpoint dimuat. Dua keluarga kernel utama dikerahkan:
`svdq_w4a4`: Menangani lapisan atensi dan proyeksi *Multi-Layer Perceptron* (MLP) yang memakan porsi komputasi terbesar.
`awq_w4a16`: Menggunakan bobot 4-bit dengan aktivasi 16-bit khusus untuk lapisan normalisasi adaptif (*adaptive normalization*) yang sangat sensitif terhadap presisi.
Apa Dampak Nyata pada Kinerja Perangkat Keras?
Angka laboratorium sering kali menipu, tetapi mari lihat hasil benchmark riil pada GPU NVIDIA RTX PRO 6000 arsitektur Blackwell dengan resolusi 1024x1024 piksel menggunakan checkpoint ERNIE-Image-Turbo.
Konfigurasi baseline BF16 standar memakan VRAM sebesar 31,1 GB dengan waktu proses 3,00 detik. Ketika beralih ke Nunchaku Lite NVFP4, penggunaan memori langsung terjun bebas ke 20,6 GB—penghematan hampir sepertiga—sambil mempercepat waktu inferensi menjadi 2,27 detik.
Coba tambahkan optimasi `torch.compile` ke dalam loop:
```python pipe.transformer.compile(fullgraph=True) ```
Lonjakan performa langsung terasa. Waktu proses total terpangkas tajam hingga 1,68 detik dengan speedup mencapai 1.8x dari baseline awal. Jika VRAM masih menjadi hambatan utama, kuantisasi tambahan pada encoder teks menggunakan bitsandbytes NF4 akan merontokkan total peak VRAM hingga menyentuh angka 16,0 GB.
Perangkat Keras Apa Saja yang Didukung?
Tidak semua GPU diciptakan setara untuk menangani matematika presisi rendah ini. Skema `svdq_w4a4` dengan presisi `nvfp4` menuntut arsitektur GPU NVIDIA Blackwell terbaru—seperti seri RTX 50, RTX PRO 6000, atau B200.
Sementara itu, bagi pengguna jajaran kartu grafis Turing, Ampere, atau Ada Lovelace (seperti seri RTX 30, RTX 40, A100, hingga L40S), sistem secara otomatis mengarahkan ke varian INT4. Arsitektur lama seperti Volta dan Hopper belum mendapat dukungan kernel 4-bit ini, dan sistem akan langsung memberikan peringatan validasi pada saat proses pemuatan dimulai untuk mencegah kesalahan output.
Batasan Apa yang Masih Harus Dihadapi?
Meskipun integrasi ini mempermudah adopsi secara masif, ada kompromi arsitektural yang harus dibayar. Tanpa kernel terfusi (fused kernels) yang dirancang khusus per model seperti pada engine Nunchaku murni, versi Nunchaku Lite harus rela kehilangan sedikit potensi kecepatan maksimal demi fleksibilitas universal.
Para insinyur kini sedang merancang mekanisme kernel caching dinamis yang dapat merakit instruksi terfusi secara on-the-fly tanpa membebani waktu inisialisasi awal. Sampai solusi itu matang di rilis berikutnya, Nunchaku Lite tetap menjadi jalan pintas terbaik untuk meruntuhkan tembok pembatas VRAM.

OpenAI Luncurkan GPT-6 Astra, Indikasikan Tonggak Pencapaian AGI
04 MNT BACA
Di Balik Truk Murah $25.000 Slate: Siapa yang Sebenarnya Membayar Modifikasinya?
11 MNT BACA
Gubernur Texas Bekukan Anggaran Kamera Flock: Saat $30 Juta Berakhir di Bayang-Bayang Privasi
14 MNT BACAMemangkas VRAM Model Diffusi Tanpa Kehilangan Presisi Lewat Nunchaku Lite
Integrasi native Nunchaku Lite di Hugging Face Diffusers memotong penggunaan VRAM hingga setengahnya tanpa kompilasi CUDA lokal.
Model ini tidak salah. Ia hanya tidak sedang berpikir.”
Apa yang Sebenarnya Terjadi Saat Model Diffusi Dikuantisasi?
Bayangkan sebuah model diffusi sebagai pabrik raksasa yang memproses jutaan produk sekaligus di jalur perakitan. Jalur perakitan itu adalah bobot (weights) dan aktivasi (activations) dari jaringan neural. Standar kuantisasi 4-bit biasanya gagal pada model diffusi karena adanya outliers—nilai ekstrem yang merusak akurasi jika dipaksa masuk ke rentang angka sempit.
SVDQuant menyelesaikan masalah ini dengan kecerdikan tingkat tinggi. Bayangkan kamu memisahkan bagian manajer pabrik yang rewel (outliers) ke ruangan khusus berpresisi tinggi (cabang low-rank 16-bit), sementara para pekerja pabrik lainnya cukup menggunakan instruksi ringkas 4-bit. Hasilnya adalah metode W4A4 (4-bit bobot dan aktivasi) yang berjalan mulus tanpa kehilangan detail visual.
Bagaimana Nunchaku Lite Menghapus Kebutuhan Kompilasi CUDA
Versi asli mesin inferensi Nunchaku terkenal sangat cepat, namun ia menuntut modifikasi mendalam dan kompilasi CUDA lokal yang melelahkan bagi setiap arsitektur model baru. Nunchaku Lite hadir untuk menjembatani hambatan tersebut.
Bayangkan Nunchaku Lite sebagai adaptor universal listrik yang langsung pas di stopkontak mana pun tanpa perlu membongkar kabel dinding. Diffusers kini dapat memuat checkpoint gaya Nunchaku secara native menggunakan perintah standar `from_pretrained()`.
Di balik layar, Nunchaku Lite menambal modul `nn.Linear` standar dari model Diffusers dengan lapisan runtime khusus sesaat sebelum checkpoint dimuat. Dua keluarga kernel utama dikerahkan:
`svdq_w4a4`: Menangani lapisan atensi dan proyeksi *Multi-Layer Perceptron* (MLP) yang memakan porsi komputasi terbesar.
`awq_w4a16`: Menggunakan bobot 4-bit dengan aktivasi 16-bit khusus untuk lapisan normalisasi adaptif (*adaptive normalization*) yang sangat sensitif terhadap presisi.
Apa Dampak Nyata pada Kinerja Perangkat Keras?
Angka laboratorium sering kali menipu, tetapi mari lihat hasil benchmark riil pada GPU NVIDIA RTX PRO 6000 arsitektur Blackwell dengan resolusi 1024x1024 piksel menggunakan checkpoint ERNIE-Image-Turbo.
Konfigurasi baseline BF16 standar memakan VRAM sebesar 31,1 GB dengan waktu proses 3,00 detik. Ketika beralih ke Nunchaku Lite NVFP4, penggunaan memori langsung terjun bebas ke 20,6 GB—penghematan hampir sepertiga—sambil mempercepat waktu inferensi menjadi 2,27 detik.
Coba tambahkan optimasi `torch.compile` ke dalam loop:
```python pipe.transformer.compile(fullgraph=True) ```
Lonjakan performa langsung terasa. Waktu proses total terpangkas tajam hingga 1,68 detik dengan speedup mencapai 1.8x dari baseline awal. Jika VRAM masih menjadi hambatan utama, kuantisasi tambahan pada encoder teks menggunakan bitsandbytes NF4 akan merontokkan total peak VRAM hingga menyentuh angka 16,0 GB.
Perangkat Keras Apa Saja yang Didukung?
Tidak semua GPU diciptakan setara untuk menangani matematika presisi rendah ini. Skema `svdq_w4a4` dengan presisi `nvfp4` menuntut arsitektur GPU NVIDIA Blackwell terbaru—seperti seri RTX 50, RTX PRO 6000, atau B200.
Sementara itu, bagi pengguna jajaran kartu grafis Turing, Ampere, atau Ada Lovelace (seperti seri RTX 30, RTX 40, A100, hingga L40S), sistem secara otomatis mengarahkan ke varian INT4. Arsitektur lama seperti Volta dan Hopper belum mendapat dukungan kernel 4-bit ini, dan sistem akan langsung memberikan peringatan validasi pada saat proses pemuatan dimulai untuk mencegah kesalahan output.
Batasan Apa yang Masih Harus Dihadapi?
Meskipun integrasi ini mempermudah adopsi secara masif, ada kompromi arsitektural yang harus dibayar. Tanpa kernel terfusi (fused kernels) yang dirancang khusus per model seperti pada engine Nunchaku murni, versi Nunchaku Lite harus rela kehilangan sedikit potensi kecepatan maksimal demi fleksibilitas universal.
Para insinyur kini sedang merancang mekanisme kernel caching dinamis yang dapat merakit instruksi terfusi secara on-the-fly tanpa membebani waktu inisialisasi awal. Sampai solusi itu matang di rilis berikutnya, Nunchaku Lite tetap menjadi jalan pintas terbaik untuk meruntuhkan tembok pembatas VRAM.