
Membongkar Inkling oleh Thinking Machines: Paradigma Baru Model Penalaran Ringan
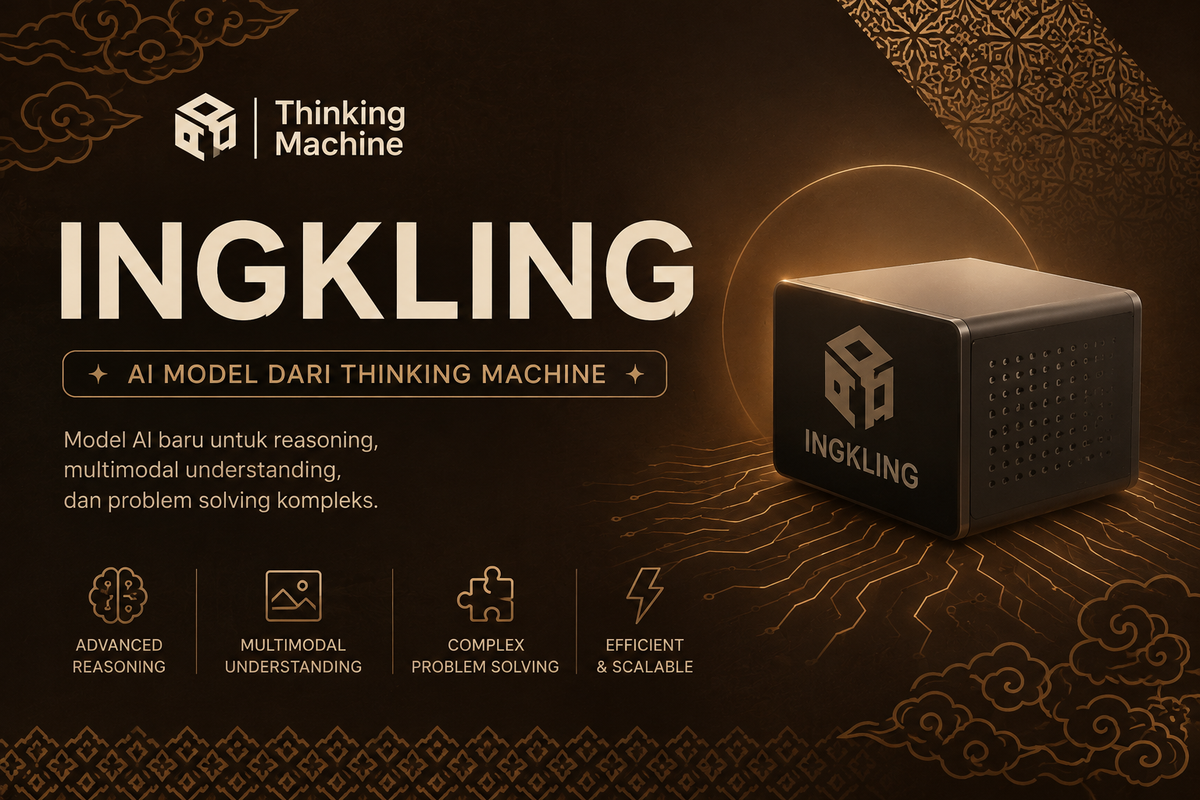
Thinking Machines memperkenalkan Inkling, sebuah terobosan arsitektur model bahasa yang mengoptimalkan inferensi berbiaya rendah tanpa mengorbankan ketajaman logika.
Model ini tidak salah. Ia hanya tidak sedang berpikir.”
Membedah Arsitektur Inkling
Pendekatan konvensional dalam meningkatkan kapabilitas penalaran (reasoning) LLM kerap berpusat pada penambahan parameter secara horizontal atau penerapan mekanisme test-time compute yang rakus daya. Thinking Machines mengambil jalur berbeda melalui Inkling. Arsitektur ini dirancang untuk memaksimalkan efisiensi representasi token dengan mengintegrasikan kompresi state internal yang lebih ketat.
Secara teknis, Inkling memangkas redudansi dalam jalur propagasi forward-pass. Alih-alih mengandalkan lapisan attention yang membengkak, model ini menggunakan mekanisme routing dinamis yang menyaring jalur komputasi hanya pada parameter yang relevan dengan konteks kognitif spesifik. Hasilnya adalah penurunan drastis pada penggunaan memori VRAM saat fase inferensi berlangsung, menjadikannya sangat kompetitif untuk dijalankan pada perangkat keras kelas edge maupun server berbiaya operasional rendah.
Mekanisme Inferensi dan Optimalisasi Kognitif
Tantangan terbesar dalam merancang model berukuran kecil namun cerdas adalah menjaga integritas penalaran multi-langkah (multi-step reasoning). Inkling mengatasi hal ini melalui reorganisasi struktur latent space selama fase pelatihan lanjutan (post-training). Model dilatih untuk memprioritaskan rantai penalaran yang padat informasi, meminimalkan token sia-sia yang lazim ditemukan pada model generatif konvensional.
Optimalisasi ini tidak hanya berdampak pada kecepatan pemrosesan (tokens per second), tetapi juga menurunkan total Cost of Ownership (TCO) bagi infrastruktur cloud. Bagi para insinyur sistem, efisiensi semacam ini membuka peluang implementasi agen AI otonom yang membutuhkan siklus respons cepat tanpa menguras anggaran komputasi.
Implikasi Industri dan Masa Depan Open-Weights
Kehadiran Inkling menegaskan pergeseran paradigma dari 'bigger is better' menuju efisiensi arsitektural yang berkelanjutan. Di era di mana otonomi perangkat keras menjadi kunci kedaulatan teknologi, model dengan rasio performa terhadap daya yang tinggi adalah aset strategis.
Dengan dirilisnya model ini ke ranah open-weights, Thinking Machines tidak hanya mendemokratisasi akses terhadap penalaran tingkat lanjut, tetapi juga memicu gelombang inovasi baru di kalangan periset independen. Masa depan kecerdasan buatan tampaknya tidak lagi ditentukan oleh seberapa besar ukuran model dapat diskalakan, melainkan seberapa cerdas arsitektur tersebut didesain dalam batas-batas fisik perangkat keras.

OpenAI Luncurkan GPT-6 Astra, Indikasikan Tonggak Pencapaian AGI
04 MNT BACA
Di Balik Truk Murah $25.000 Slate: Siapa yang Sebenarnya Membayar Modifikasinya?
11 MNT BACA
Gubernur Texas Bekukan Anggaran Kamera Flock: Saat $30 Juta Berakhir di Bayang-Bayang Privasi
14 MNT BACAMembongkar Inkling oleh Thinking Machines: Paradigma Baru Model Penalaran Ringan
Thinking Machines memperkenalkan Inkling, sebuah terobosan arsitektur model bahasa yang mengoptimalkan inferensi berbiaya rendah tanpa mengorbankan ketajaman logika.
Model ini tidak salah. Ia hanya tidak sedang berpikir.”
Membedah Arsitektur Inkling
Pendekatan konvensional dalam meningkatkan kapabilitas penalaran (reasoning) LLM kerap berpusat pada penambahan parameter secara horizontal atau penerapan mekanisme test-time compute yang rakus daya. Thinking Machines mengambil jalur berbeda melalui Inkling. Arsitektur ini dirancang untuk memaksimalkan efisiensi representasi token dengan mengintegrasikan kompresi state internal yang lebih ketat.
Secara teknis, Inkling memangkas redudansi dalam jalur propagasi forward-pass. Alih-alih mengandalkan lapisan attention yang membengkak, model ini menggunakan mekanisme routing dinamis yang menyaring jalur komputasi hanya pada parameter yang relevan dengan konteks kognitif spesifik. Hasilnya adalah penurunan drastis pada penggunaan memori VRAM saat fase inferensi berlangsung, menjadikannya sangat kompetitif untuk dijalankan pada perangkat keras kelas edge maupun server berbiaya operasional rendah.
Mekanisme Inferensi dan Optimalisasi Kognitif
Tantangan terbesar dalam merancang model berukuran kecil namun cerdas adalah menjaga integritas penalaran multi-langkah (multi-step reasoning). Inkling mengatasi hal ini melalui reorganisasi struktur latent space selama fase pelatihan lanjutan (post-training). Model dilatih untuk memprioritaskan rantai penalaran yang padat informasi, meminimalkan token sia-sia yang lazim ditemukan pada model generatif konvensional.
Optimalisasi ini tidak hanya berdampak pada kecepatan pemrosesan (tokens per second), tetapi juga menurunkan total Cost of Ownership (TCO) bagi infrastruktur cloud. Bagi para insinyur sistem, efisiensi semacam ini membuka peluang implementasi agen AI otonom yang membutuhkan siklus respons cepat tanpa menguras anggaran komputasi.
Implikasi Industri dan Masa Depan Open-Weights
Kehadiran Inkling menegaskan pergeseran paradigma dari 'bigger is better' menuju efisiensi arsitektural yang berkelanjutan. Di era di mana otonomi perangkat keras menjadi kunci kedaulatan teknologi, model dengan rasio performa terhadap daya yang tinggi adalah aset strategis.
Dengan dirilisnya model ini ke ranah open-weights, Thinking Machines tidak hanya mendemokratisasi akses terhadap penalaran tingkat lanjut, tetapi juga memicu gelombang inovasi baru di kalangan periset independen. Masa depan kecerdasan buatan tampaknya tidak lagi ditentukan oleh seberapa besar ukuran model dapat diskalakan, melainkan seberapa cerdas arsitektur tersebut didesain dalam batas-batas fisik perangkat keras.