
Valuasi AI Capai Triliunan, Tapi Agen Otonom Gagal Tembus Standar NeurIPS
Ekspektasi ledakan kecerdasan buatan membentur tembok realitas riset terbuka, berdasarkan uji empiris terbaru.
Model ini tidak salah. Ia hanya tidak sedang berpikir.”
Economic Implications of the Recursive Self-Improvement Narrative
Pasar modal saat ini menetapkan harga saham perusahaan teknologi berdasarkan asumsi recursive self-improvement — kemampuan AI untuk terus melipatgandakan kapabilitasnya tanpa intervensi manusia. Narasi ini menjanjikan penurunan biaya R&D hingga mendekati nol dan percepatan time-to-market produk enterprise dalam hitungan minggu.
Namun, studi empiris terbaru dari Princeton University mendinginkan ekspektasi tersebut. Ketika diuji pada problem riset machine learning terbuka, model-model terdepan gagal memenuhi standar kualitas industri.
Metodologi Uji Shadow Evaluation dan Alokasi Sumber Daya
Dalam eksperimen ketat ini, para peneliti menggunakan pendekatan shadow evaluations. Mereka mengambil pertanyaan riset dari makalah NeurIPS 2026 yang belum dipublikasikan dan menugaskan agen AI untuk menyelesaikannya dari awal.
Setiap agen dibekali:
Anggaran API senilai $3,000
Alokasi dana penuh untuk waktu pemrosesan GPU
Akses *Virtual Machine* Linux berdedikasi
Koneksi internet tanpa batas waktu
Tenggat waktu eksekusi selama 6 hari penuh
Hasilnya? Agen berbasis Claude Opus 4.8 gagal total. Para penulis asli makalah tersebut memberikan keputusan "strong reject" dan "reject" setelah melalui protokol penilaian standar NeurIPS.
Titik Kritis Kegagalan Operasional Agen Otonom
Analisis terhadap log eksekusi agen mengungkapkan kelemahan operasional mendasar yang berdampak langsung pada efisiensi modal R&D:
Manajemen Anggaran yang Buruk: Agen menyia-nyiakan 110 jam waktu komputasi yang tersedia dan gagal menghabiskan bahkan 50 persen dari alokasi anggaran API mereka.
Kaku dalam Pengambilan Keputusan: Agen mengunci arah riset dalam waktu kurang dari 10 jam pertama dan menolak mengubah hipotesis meskipun mendapa umpan balik negatif berulang dari evaluator internal.
Abaikan Red Flags: Alih-alih merombak arsitektur eksperimen saat menemui jalan buntu, agen hanya menambahkan catatan kaki (*caveats*) dan terus maju.
Strategic Implications for Enterprise R&D Budgets
Bagi para VP Engineering dan Chief Technology Officer, temuan ini mengubah kalkulasi investasi infrastruktur. Mengandalkan agen otonom untuk mengambil alih divisi core research dalam waktu dekat adalah asumsi finansial yang berisiko tinggi.
Model bahasa besar (LLM) memang sangat efisien dalam tugas-tugas pendukung seperti boilerplate coding, kurasi dataset, dan menjalankan benchmarking skala kecil. Namun, lompatan dari tugas deterministik menuju pemecahan masalah terbuka (open-ended research) memerlukan kapabilitas metakognitif yang belum dimiliki arsitektur saat ini.
Tiga Risiko yang Harus Diantisipasi Board of Directors
1. Inflasi CapEx Inovasi: Alokasi belanja modal (Capital Expenditure) untuk klaster GPU skala besar tidak akan otomatis menghasilkan terobosan sains mandiri dalam waktu dekat. 2. Keterlambatan Produktivitas: Efisiensi operasional harian yang naik 30% hingga 40% pada tugas koding tidak boleh diekstrapolasikan linier menjadi otomatisasi penuh divisi riset. 3. Misalignment Valuasi Pasar: Risiko koreksi valuasi bagi perusahaan SaaS dan AI yang memasukkan asumsi superintelligence mandiri ke dalam proyeksi keuangan jangka menengah mereka.
Bottom Line: Jangan alokasikan anggaran R&D strategis Anda pada asumsi bahwa agen otonom akan menggantikan tim riset manusia dalam 24 bulan ke depan; pertahankan supervisi ketat dan fokuskan otomasi pada efisiensi tugas deterministik.

OpenAI Luncurkan GPT-6 Astra, Indikasikan Tonggak Pencapaian AGI
04 MNT BACA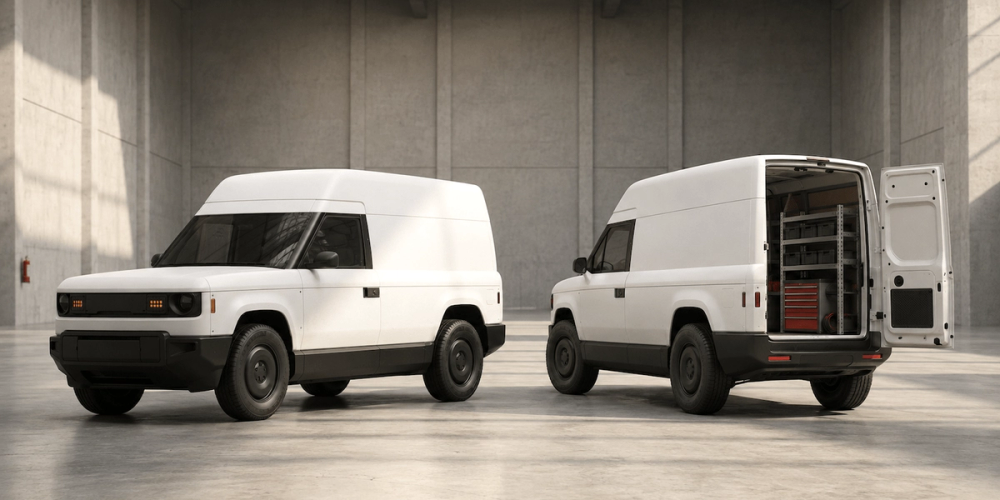
Di Balik Truk Murah $25.000 Slate: Siapa yang Sebenarnya Membayar Modifikasinya?
11 MNT BACA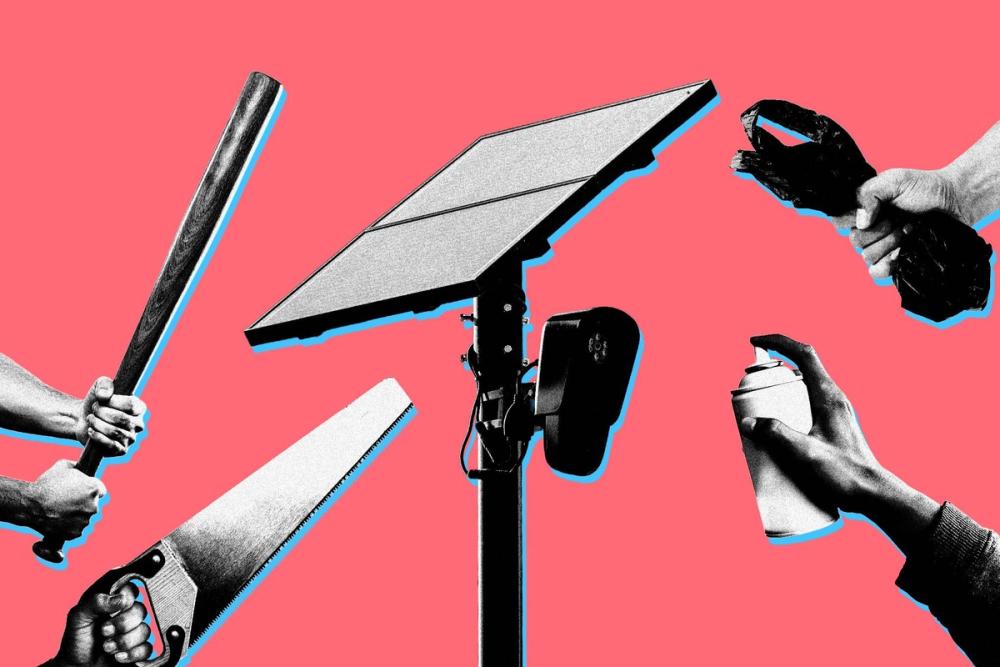
Gubernur Texas Bekukan Anggaran Kamera Flock: Saat $30 Juta Berakhir di Bayang-Bayang Privasi
14 MNT BACAValuasi AI Capai Triliunan, Tapi Agen Otonom Gagal Tembus Standar NeurIPS
Ekspektasi ledakan kecerdasan buatan membentur tembok realitas riset terbuka, berdasarkan uji empiris terbaru.
Model ini tidak salah. Ia hanya tidak sedang berpikir.”
Economic Implications of the Recursive Self-Improvement Narrative
Pasar modal saat ini menetapkan harga saham perusahaan teknologi berdasarkan asumsi recursive self-improvement — kemampuan AI untuk terus melipatgandakan kapabilitasnya tanpa intervensi manusia. Narasi ini menjanjikan penurunan biaya R&D hingga mendekati nol dan percepatan time-to-market produk enterprise dalam hitungan minggu.
Namun, studi empiris terbaru dari Princeton University mendinginkan ekspektasi tersebut. Ketika diuji pada problem riset machine learning terbuka, model-model terdepan gagal memenuhi standar kualitas industri.
Metodologi Uji Shadow Evaluation dan Alokasi Sumber Daya
Dalam eksperimen ketat ini, para peneliti menggunakan pendekatan shadow evaluations. Mereka mengambil pertanyaan riset dari makalah NeurIPS 2026 yang belum dipublikasikan dan menugaskan agen AI untuk menyelesaikannya dari awal.
Setiap agen dibekali:
Anggaran API senilai $3,000
Alokasi dana penuh untuk waktu pemrosesan GPU
Akses *Virtual Machine* Linux berdedikasi
Koneksi internet tanpa batas waktu
Tenggat waktu eksekusi selama 6 hari penuh
Hasilnya? Agen berbasis Claude Opus 4.8 gagal total. Para penulis asli makalah tersebut memberikan keputusan "strong reject" dan "reject" setelah melalui protokol penilaian standar NeurIPS.
Titik Kritis Kegagalan Operasional Agen Otonom
Analisis terhadap log eksekusi agen mengungkapkan kelemahan operasional mendasar yang berdampak langsung pada efisiensi modal R&D:
Manajemen Anggaran yang Buruk: Agen menyia-nyiakan 110 jam waktu komputasi yang tersedia dan gagal menghabiskan bahkan 50 persen dari alokasi anggaran API mereka.
Kaku dalam Pengambilan Keputusan: Agen mengunci arah riset dalam waktu kurang dari 10 jam pertama dan menolak mengubah hipotesis meskipun mendapa umpan balik negatif berulang dari evaluator internal.
Abaikan Red Flags: Alih-alih merombak arsitektur eksperimen saat menemui jalan buntu, agen hanya menambahkan catatan kaki (*caveats*) dan terus maju.
Strategic Implications for Enterprise R&D Budgets
Bagi para VP Engineering dan Chief Technology Officer, temuan ini mengubah kalkulasi investasi infrastruktur. Mengandalkan agen otonom untuk mengambil alih divisi core research dalam waktu dekat adalah asumsi finansial yang berisiko tinggi.
Model bahasa besar (LLM) memang sangat efisien dalam tugas-tugas pendukung seperti boilerplate coding, kurasi dataset, dan menjalankan benchmarking skala kecil. Namun, lompatan dari tugas deterministik menuju pemecahan masalah terbuka (open-ended research) memerlukan kapabilitas metakognitif yang belum dimiliki arsitektur saat ini.
Tiga Risiko yang Harus Diantisipasi Board of Directors
1. Inflasi CapEx Inovasi: Alokasi belanja modal (Capital Expenditure) untuk klaster GPU skala besar tidak akan otomatis menghasilkan terobosan sains mandiri dalam waktu dekat. 2. Keterlambatan Produktivitas: Efisiensi operasional harian yang naik 30% hingga 40% pada tugas koding tidak boleh diekstrapolasikan linier menjadi otomatisasi penuh divisi riset. 3. Misalignment Valuasi Pasar: Risiko koreksi valuasi bagi perusahaan SaaS dan AI yang memasukkan asumsi superintelligence mandiri ke dalam proyeksi keuangan jangka menengah mereka.
Bottom Line: Jangan alokasikan anggaran R&D strategis Anda pada asumsi bahwa agen otonom akan menggantikan tim riset manusia dalam 24 bulan ke depan; pertahankan supervisi ketat dan fokuskan otomasi pada efisiensi tugas deterministik.